gho_clean(), sdg_clean() et
ghe_clean() renvoient par défaut des tibbles
dsir_data avec la même structure de base à 15 colonnes.
Utilisez output = "tibble" pour obtenir un tibble
ordinaire. Quelques exemples ggplot2 couvrent ainsi les
graphiques courants : tendances avec bandes d’incertitude, ventilations
par sexe ou âge, comparaisons entre pays avec intervalles, graphiques en
haltères et suivi des progrès avec aarr().
La méthode expérimentale plot() permet de tracer des
tendances annuelles et des comparaisons entre pays pour une même année,
après vérification des données. Les exemples ggplot2
ci-dessous permettent d’autres analyses et personnalisations. Le code et
les libellés des graphiques sont communs à la version anglaise ; les
explications sont traduites ici. Pour l’installation et l’accès aux
données, consultez les premiers pas avec
DSIR.
Données d’exemple
Les graphiques utilisent la structure nettoyée. Dans une analyse réelle, les données pourraient provenir des API :
ncd <- gho_data("NCDMORT3070", spatial_type = "country",
                area = c("PHL", "VNM", "KHM", "MNG", "FJI", "LAO")) |>
  gho_clean()
Pour permettre la construction hors ligne et garantir la
reproductibilité, nous simulons un petit jeu de données de même
structure : un indicateur illustratif de mortalité prématurée due aux
maladies non transmissibles (MNT), pour six pays du Pacifique occidental
entre 2000 et 2023. dim1 indique le sexe ; low
et high contiennent les bornes illustratives.
Toutes les valeurs et tous les graphiques de cette page reposent sur des données simulées, et non sur des estimations publiées par l’OMS.
set.seed(416)

countries <- who_countries |>
  filter(iso3 %in% c("PHL", "VNM", "KHM", "MNG", "FJI", "LAO")) |>
  select(iso3, location_name = name_short)

grid <- expand.grid(
  iso3 = countries$iso3,
  year = 2000:2023,
  dim1 = c("SEX_BTSX", "SEX_MLE", "SEX_FMLE"),
  stringsAsFactors = FALSE
) |>
  as_tibble()

base_rate <- c(PHL = 30, VNM = 26, KHM = 28, MNG = 34, FJI = 31, LAO = 29)
decline   <- c(PHL = 0.010, VNM = 0.016, KHM = 0.012,
               MNG = 0.006, FJI = -0.002, LAO = 0.011)
sex_shift <- c(SEX_BTSX = 1, SEX_MLE = 1.25, SEX_FMLE = 0.8)

ncd <- grid |>
  left_join(countries, by = "iso3") |>
  mutate(
    value_num = base_rate[iso3] * (1 - decline[iso3])^(year - 2000) *
      sex_shift[dim1] * exp(rnorm(n(), sd = 0.01)),
    low       = value_num * 0.93,
    high      = value_num * 1.07,
    source    = "gho",
    id        = "NCDMORT3070",
    indicator = "Probability of premature death from NCDs (%)",
    location  = iso3,
    year      = as.integer(year),
    value     = as.character(round(value_num, 1)),
    series    = NA_character_,
    dim2      = NA_character_,
    dim3      = NA_character_
  ) |>
  select(source, id, indicator, location, iso3, location_name, year,
         value, value_num, low, high, series, dim1, dim2, dim3)

ncd
#> # A tibble: 432 × 15
#>    source id        indicator location iso3  location_name  year value value_num
#>    <chr>  <chr>     <chr>     <chr>    <chr> <chr>         <int> <chr>     <dbl>
#>  1 gho    NCDMORT3… Probabil… KHM      KHM   Cambodia       2000 27.9       27.9
#>  2 gho    NCDMORT3… Probabil… FJI      FJI   Fiji           2000 30.9       30.9
#>  3 gho    NCDMORT3… Probabil… LAO      LAO   Lao PDR        2000 29.8       29.8
#>  4 gho    NCDMORT3… Probabil… MNG      MNG   Mongolia       2000 33.6       33.6
#>  5 gho    NCDMORT3… Probabil… PHL      PHL   Philippines    2000 29.8       29.8
#>  6 gho    NCDMORT3… Probabil… VNM      VNM   Viet Nam       2000 26.2       26.2
#>  7 gho    NCDMORT3… Probabil… KHM      KHM   Cambodia       2001 27.4       27.4
#>  8 gho    NCDMORT3… Probabil… FJI      FJI   Fiji           2001 31.2       31.2
#>  9 gho    NCDMORT3… Probabil… LAO      LAO   Lao PDR        2001 28.8       28.8
#> 10 gho    NCDMORT3… Probabil… MNG      MNG   Mongolia       2001 33.9       33.9
#> # ℹ 422 more rows
#> # ℹ 6 more variables: low <dbl>, high <dbl>, series <chr>, dim1 <chr>,
#> #   dim2 <chr>, dim3 <chr>
Graphiques S3 expérimentaux
Les résultats des fonctions de nettoyage conservent les métadonnées d’acquisition et de nettoyage dans les attributs de l’objet. La table simulée ci-dessus ne possède pas d’historique d’acquisition ; la conversion explicite n’en crée pas. Les unités sont définies ici dans le cadre de la simulation.
data.plot <- ncd %>%
  filter(dim1 == "SEX_BTSX") %>%
  mutate(unit = "percent") %>%
  as_dsir_data()

plot(data.plot, type = "trend", country = "PHL", interval = TRUE)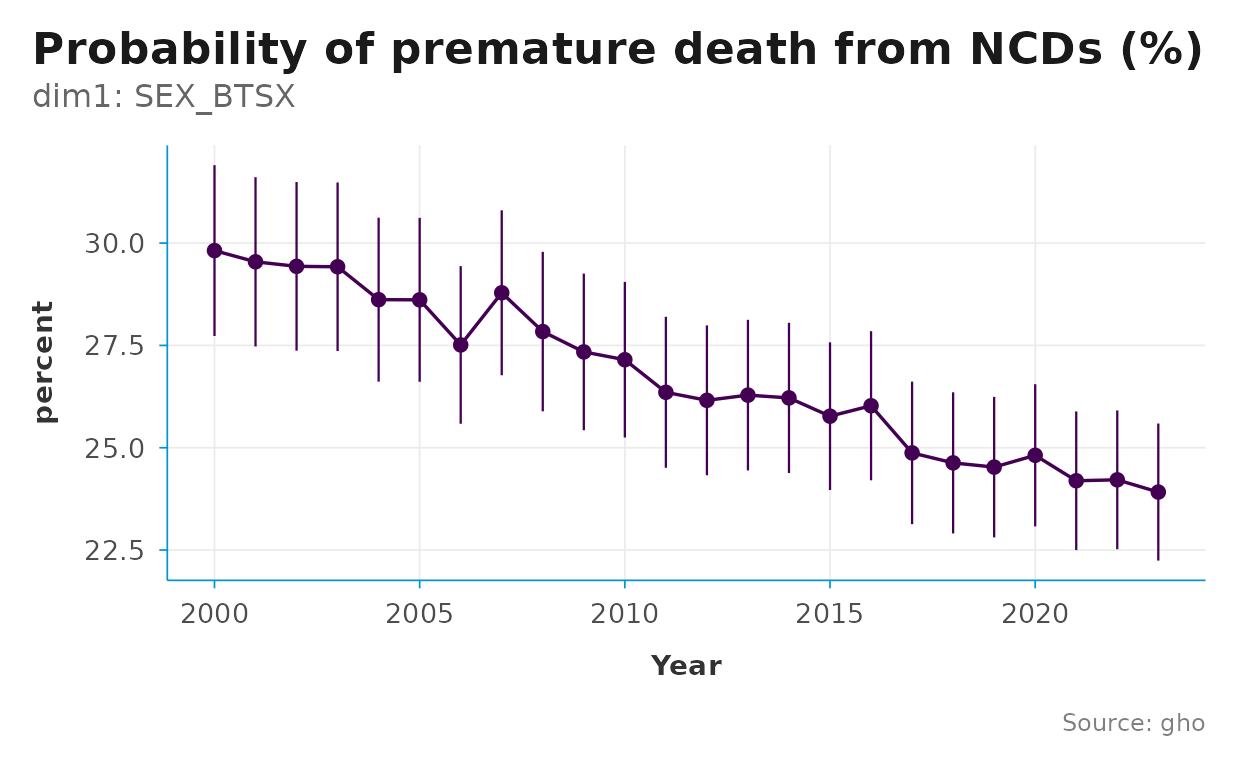
plot(data.plot, type = "compare", year = 2023, interval = TRUE) +
  labs(title = "Illustrative country comparison")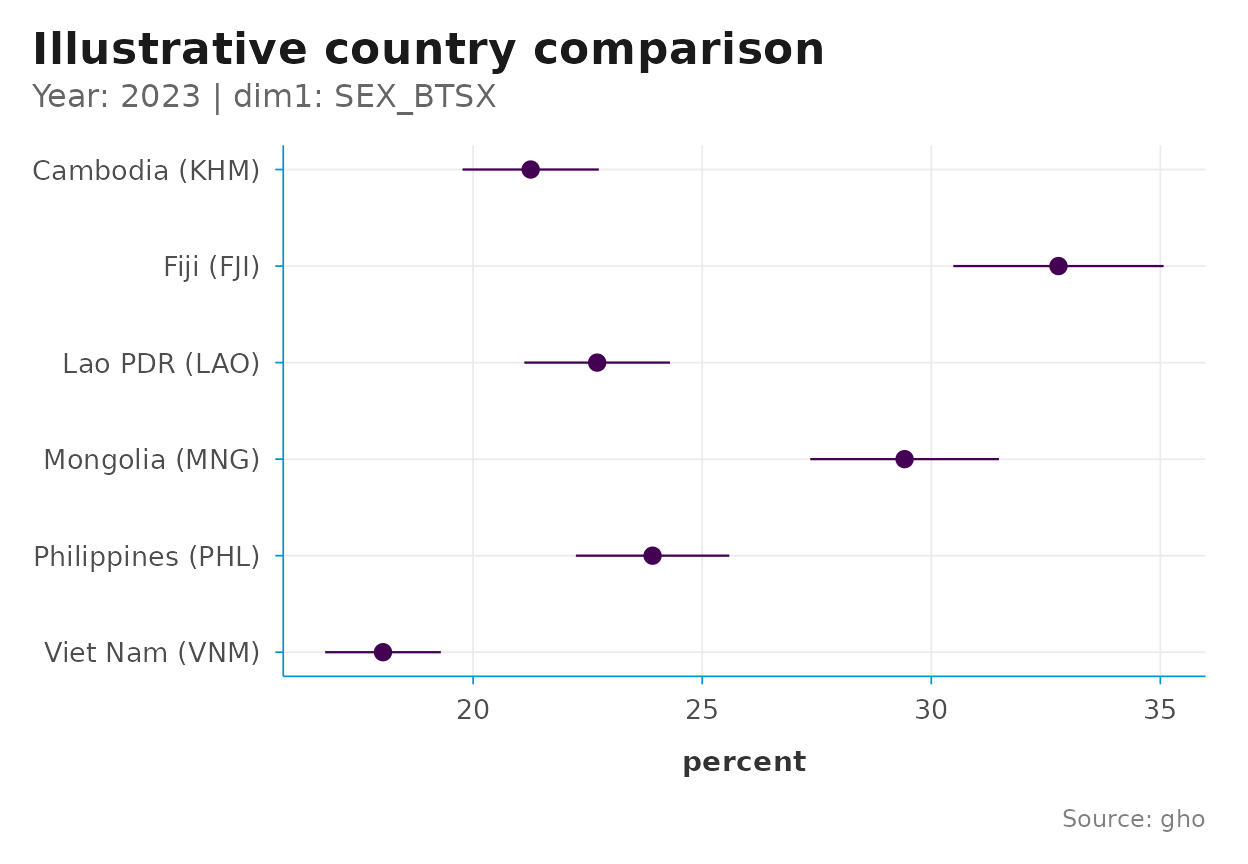
Les résultats sont des objets ggplot ordinaires. Les bornes fournies
sont représentées par des intervalles, sans supposer de niveau de
confiance. Une comparaison utilise une année commune. Les lignes de
tendance sont interrompues en cas de valeur manquante ou d’écart
supérieur à un an. Aucune méthode n’agrège les données ni ne convertit
les unités. Sélectionnez un seul indicateur, une seule série ou mesure
et une seule unité, puis filtrez les autres strates ou indiquez les
colonnes avec group et facet. Par exemple, les
tendances par sexe peuvent utiliser group = "dim1" et
facet = "iso3". Si des dimensions variables ont été omises
lors du nettoyage, recommencez avec les options de conservation. Après
modification de champs nécessaires au graphique marqués
needs_review, vérifiez les données puis utilisez des
correspondances ggplot explicites.
Tendances avec une bande d’incertitude
low et high correspondent directement à
geom_ribbon(). Filtrez d’abord une seule strate : ici, les
deux sexes réunis (dim1 == "SEX_BTSX").
theme_dsi_facet() est la variante du thème adaptée aux
facettes.
ncd |>
  filter(dim1 == "SEX_BTSX") |>
  ggplot(aes(year, value_num)) +
  geom_ribbon(aes(ymin = low, ymax = high), fill = "#0093D5", alpha = 0.2) +
  geom_line(color = "#0093D5", linewidth = 0.7) +
  facet_wrap(~ location_name) +
  labs(
    title    = "Premature NCD mortality is declining in most countries",
    subtitle = "Probability of premature death from NCDs, both sexes, 2000-2023",
    x = NULL, y = "%",
    caption  = "Simulated data for illustration."
  ) +
  theme_dsi_facet()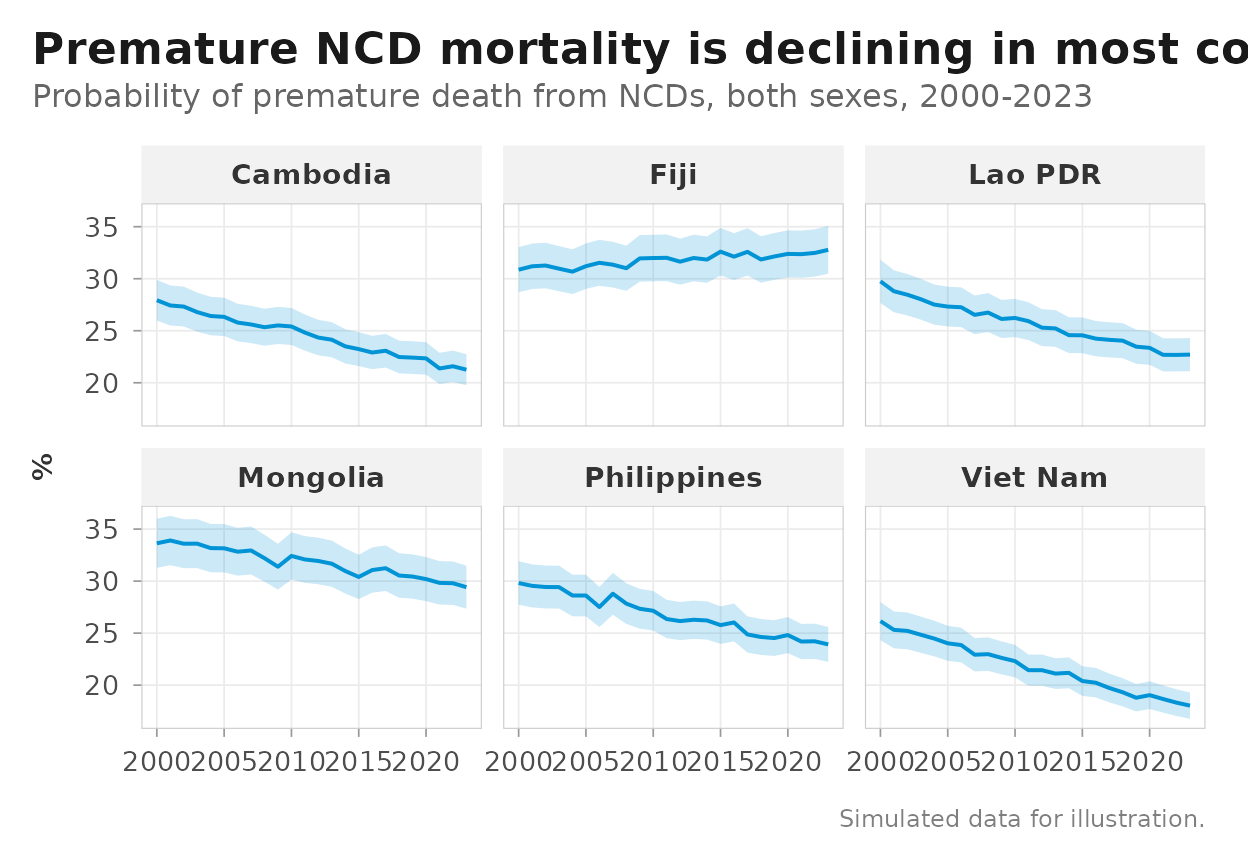
Les intervalles simulés servent à illustrer le graphique. Pour une analyse réelle, vérifiez la définition des intervalles d’incertitude dans la source.
Ventilations à partir de dim1 / dim2 / dim3
Dans l’ancien GHO, les ventilations par sexe, âge ou autre catégorie
figurent dans dim1, dim2 et dim3.
Associez la strate à colour et utilisez une palette
accessible aux personnes daltoniennes, comme
scale_color_viridis_d() de ggplot2. Les
données simulées reprennent ces dimensions positionnelles ; adaptez les
colonnes aux dimensions nommées lorsque vous utilisez xMart.
ncd |>
  filter(dim1 %in% c("SEX_MLE", "SEX_FMLE")) |>
  ggplot(aes(year, value_num, color = dim1)) +
  geom_line(linewidth = 0.7) +
  facet_wrap(~ location_name) +
  scale_color_viridis_d(end = 0.6,
                        labels = c(SEX_FMLE = "Female", SEX_MLE = "Male")) +
  labs(
    title    = "Men die prematurely from NCDs more often than women",
    x = NULL, y = "%", color = NULL,
    caption  = "Simulated data for illustration."
  ) +
  theme_dsi_facet()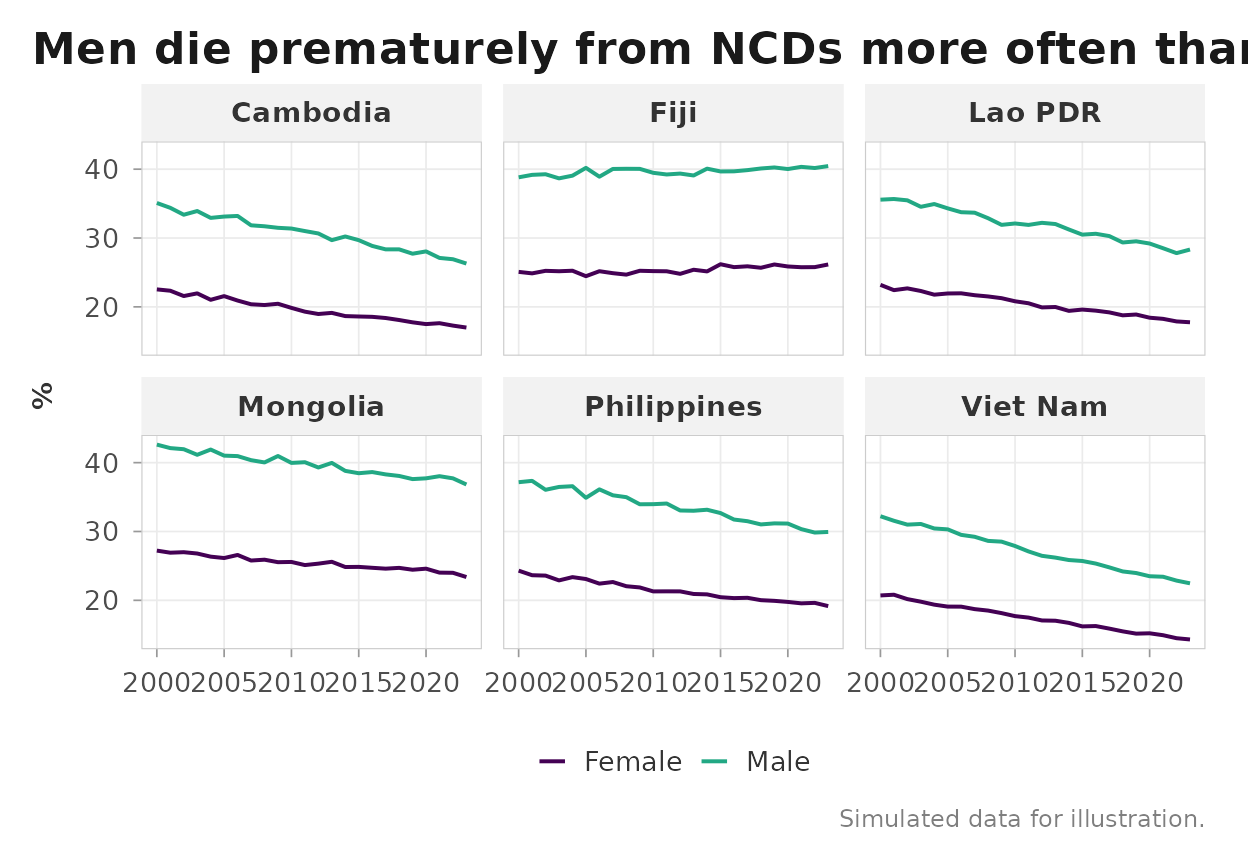
Comparaison entre pays avec intervalles
Pour comparer les pays à un moment donné avec leurs intervalles
d’incertitude, sélectionnez la dernière année par pays et utilisez
geom_pointrange(). Trier l’axe selon la valeur facilite la
lecture. Ici, la dernière année est identique pour tous les pays ;
vérifiez ce point avec des données réelles.
latest <- ncd |>
  filter(dim1 == "SEX_BTSX") |>
  slice_max(year, by = iso3)

ggplot(latest, aes(value_num, reorder(location_name, value_num))) +
  geom_pointrange(aes(xmin = low, xmax = high),
                  color = "#0093D5", linewidth = 0.7) +
  labs(
    title   = "Premature NCD mortality, 2023",
    x = "%", y = NULL,
    caption = "Point estimate and 95% interval. Simulated data."
  ) +
  theme_dsi()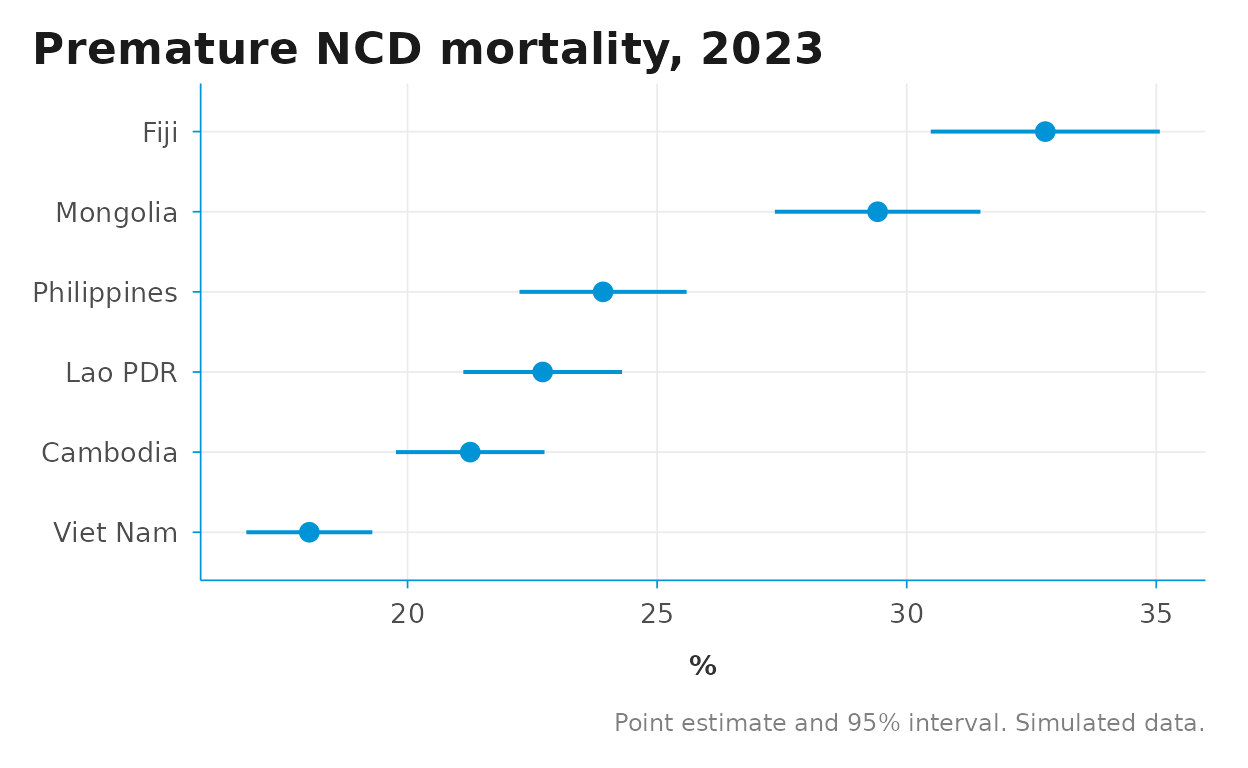
Graphique en haltères pour comparer les progrès
Un graphique en haltères compare deux dates par pays. Construisez une table large à partir de deux sélections filtrées et d’une jointure, sans package supplémentaire de restructuration. Les couleurs proviennent de la palette Okabe–Ito, adaptée aux personnes daltoniennes.
start <- ncd |>
  filter(dim1 == "SEX_BTSX", year == 2000) |>
  select(location_name, start = value_num)
end <- ncd |>
  filter(dim1 == "SEX_BTSX", year == 2023) |>
  select(location_name, end = value_num)

dumbbell <- start |>
  left_join(end, by = "location_name") |>
  mutate(
    direction     = ifelse(end < start, "Decline", "Increase"),
    location_name = reorder(location_name, start)
  )

ggplot(dumbbell) +
  geom_segment(aes(x = start, xend = end,
                   y = location_name, yend = location_name,
                   color = direction),
               linewidth = 1.5) +
  geom_point(aes(start, location_name), size = 3, color = "grey65") +
  geom_point(aes(end, location_name, color = direction), size = 3) +
  scale_color_manual(values = c(Decline = "#0072B2", Increase = "#D55E00")) +
  labs(
    title   = "Change in premature NCD mortality, 2000 to 2023",
    x = "%", y = NULL, color = NULL,
    caption = "Grey dot = 2000, colored dot = 2023. Simulated data."
  ) +
  theme_dsi()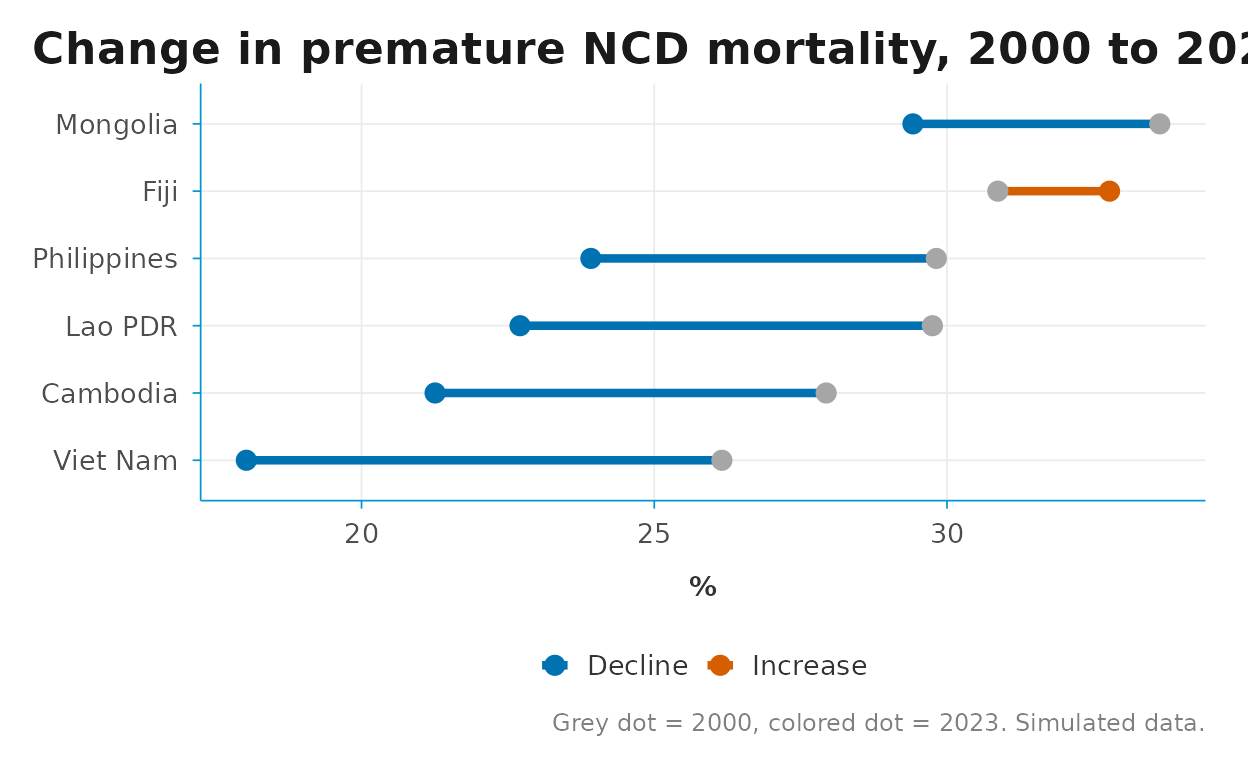
Suivre les progrès avec aarr()
aarr() calcule le taux annuel moyen de réduction (AARR),
une mesure courante du suivi des progrès à l’OMS et à l’UNICEF. Elle
s’utilise directement dans summarise() avec
.by sur les données nettoyées. Attention au signe :
une valeur positive indique une baisse de
l’indicateur.
progress <- ncd |>
  filter(dim1 == "SEX_BTSX") |>
  summarise(aarr = aarr(year, value_num), .by = c(iso3, location_name))

progress |>
  mutate(aarr_pct = round(100 * aarr, 1)) |>
  arrange(desc(aarr))
#> # A tibble: 6 × 4
#>   iso3  location_name     aarr aarr_pct
#>   <chr> <chr>            <dbl>    <dbl>
#> 1 VNM   Viet Nam       0.0159       1.6
#> 2 KHM   Cambodia       0.0117       1.2
#> 3 LAO   Lao PDR        0.0112       1.1
#> 4 PHL   Philippines    0.00995      1
#> 5 MNG   Mongolia       0.00600      0.6
#> 6 FJI   Fiji          -0.00240     -0.2
Une projection simple prolonge la dernière valeur selon l’AARR observé. C’est un outil d’examen rapide, qui ne remplace pas les modèles et hypothèses propres à chaque indicateur utilisés pour les projections officielles à l’horizon 2030.
latest |>
  left_join(progress, by = c("iso3", "location_name")) |>
  mutate(projected_2030 = value_num * (1 - aarr)^(2030 - year)) |>
  select(location_name, value_2023 = value_num, aarr, projected_2030) |>
  arrange(projected_2030)
#> # A tibble: 6 × 4
#>   location_name value_2023     aarr projected_2030
#>   <chr>              <dbl>    <dbl>          <dbl>
#> 1 Viet Nam            18.0  0.0159            16.1
#> 2 Cambodia            21.3  0.0117            19.6
#> 3 Lao PDR             22.7  0.0112            21.0
#> 4 Philippines         23.9  0.00995           22.3
#> 5 Mongolia            29.4  0.00600           28.2
#> 6 Fiji                32.8 -0.00240           33.3
Pour poursuivre : WHO xMart et estimations sanitaires mondiales.