gho_clean()、sdg_clean() 和
ghe_clean() 默认返回 dsir_data
tibble,保留相同的 15 列核心结构。使用 output = "tibble"
可返回普通 tibble。少量 ggplot2
示例即可覆盖常见的卫生指标图形。本教程介绍带区间的趋势图、性别或年龄分层图、森林图式的国家比较、哑铃图,以及使用
aarr() 跟踪进展。
试验性的 plot()
方法支持带数据检查的年度趋势图和同年国家比较图。其余分析和自定义图形仍可使用下文的
ggplot2
代码。代码和图中文字与英文版共用,本文翻译操作说明。需要安装或数据获取指导时,请阅读
DSIR 入门。
示例数据
下列图形使用清洗后的数据结构。实际工作可从 API 获取数据:
ncd <- gho_data("NCDMORT3070", spatial_type = "country",
                area = c("PHL", "VNM", "KHM", "MNG", "FJI", "LAO")) |>
  gho_clean()
为支持离线构建并保证可复现性,本文生成同样结构的模拟数据:六个西太平洋区域国家在
2000–2023 年的非传染性疾病(NCD)过早死亡示例指标,dim1
表示性别,low 和 high 为演示用区间上下界。
本页所有数值和图形均使用模拟数据,不是 WHO 发布的估计值。
set.seed(416)

countries <- who_countries |>
  filter(iso3 %in% c("PHL", "VNM", "KHM", "MNG", "FJI", "LAO")) |>
  select(iso3, location_name = name_short)

grid <- expand.grid(
  iso3 = countries$iso3,
  year = 2000:2023,
  dim1 = c("SEX_BTSX", "SEX_MLE", "SEX_FMLE"),
  stringsAsFactors = FALSE
) |>
  as_tibble()

base_rate <- c(PHL = 30, VNM = 26, KHM = 28, MNG = 34, FJI = 31, LAO = 29)
decline   <- c(PHL = 0.010, VNM = 0.016, KHM = 0.012,
               MNG = 0.006, FJI = -0.002, LAO = 0.011)
sex_shift <- c(SEX_BTSX = 1, SEX_MLE = 1.25, SEX_FMLE = 0.8)

ncd <- grid |>
  left_join(countries, by = "iso3") |>
  mutate(
    value_num = base_rate[iso3] * (1 - decline[iso3])^(year - 2000) *
      sex_shift[dim1] * exp(rnorm(n(), sd = 0.01)),
    low       = value_num * 0.93,
    high      = value_num * 1.07,
    source    = "gho",
    id        = "NCDMORT3070",
    indicator = "Probability of premature death from NCDs (%)",
    location  = iso3,
    year      = as.integer(year),
    value     = as.character(round(value_num, 1)),
    series    = NA_character_,
    dim2      = NA_character_,
    dim3      = NA_character_
  ) |>
  select(source, id, indicator, location, iso3, location_name, year,
         value, value_num, low, high, series, dim1, dim2, dim3)

ncd
#> # A tibble: 432 × 15
#>    source id        indicator location iso3  location_name  year value value_num
#>    <chr>  <chr>     <chr>     <chr>    <chr> <chr>         <int> <chr>     <dbl>
#>  1 gho    NCDMORT3… Probabil… KHM      KHM   Cambodia       2000 27.9       27.9
#>  2 gho    NCDMORT3… Probabil… FJI      FJI   Fiji           2000 30.9       30.9
#>  3 gho    NCDMORT3… Probabil… LAO      LAO   Lao PDR        2000 29.8       29.8
#>  4 gho    NCDMORT3… Probabil… MNG      MNG   Mongolia       2000 33.6       33.6
#>  5 gho    NCDMORT3… Probabil… PHL      PHL   Philippines    2000 29.8       29.8
#>  6 gho    NCDMORT3… Probabil… VNM      VNM   Viet Nam       2000 26.2       26.2
#>  7 gho    NCDMORT3… Probabil… KHM      KHM   Cambodia       2001 27.4       27.4
#>  8 gho    NCDMORT3… Probabil… FJI      FJI   Fiji           2001 31.2       31.2
#>  9 gho    NCDMORT3… Probabil… LAO      LAO   Lao PDR        2001 28.8       28.8
#> 10 gho    NCDMORT3… Probabil… MNG      MNG   Mongolia       2001 33.9       33.9
#> # ℹ 422 more rows
#> # ℹ 6 more variables: low <dbl>, high <dbl>, series <chr>, dim1 <chr>,
#> #   dim2 <chr>, dim3 <chr>
试验性 S3 绘图
实际清洗结果将数据获取记录和清洗记录保存在对象属性中。上面的模拟数据没有获取记录,显式转换也不会补造记录。这里将单位指定为模拟数据定义的一部分。
data.plot <- ncd %>%
  filter(dim1 == "SEX_BTSX") %>%
  mutate(unit = "percent") %>%
  as_dsir_data()

plot(data.plot, type = "trend", country = "PHL", interval = TRUE)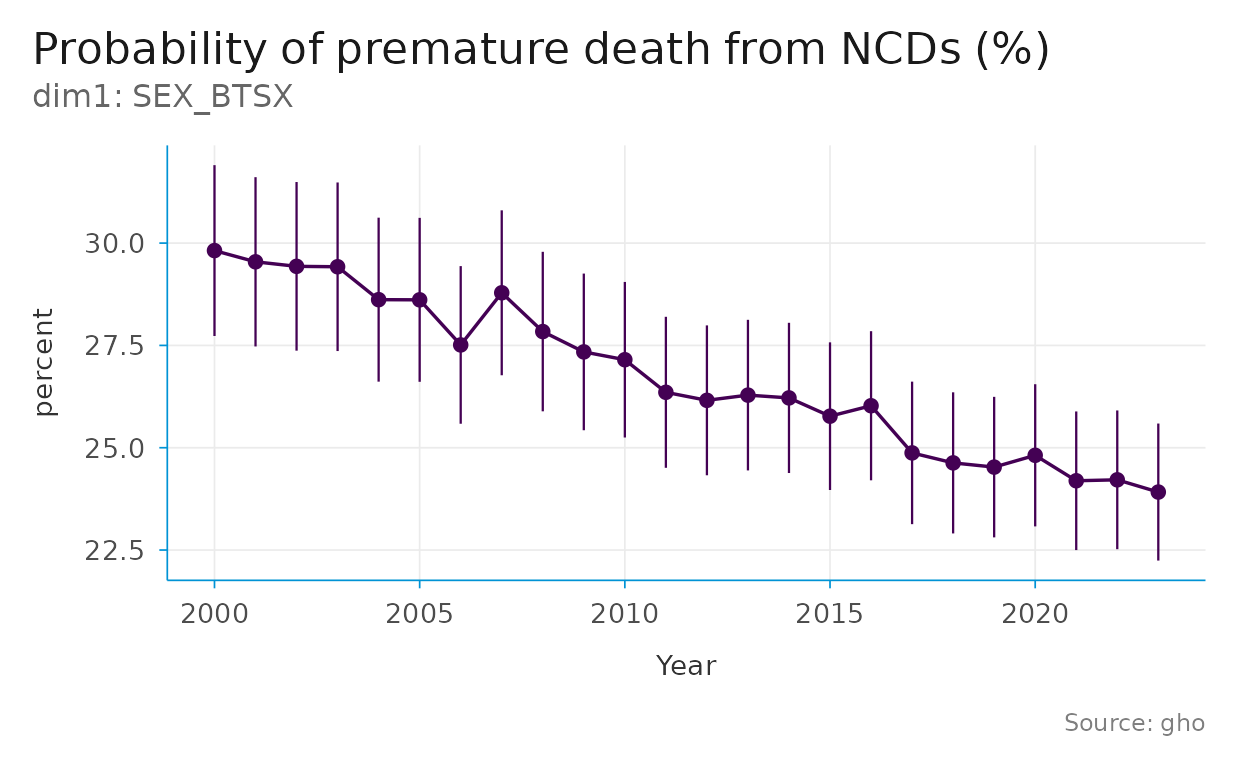
plot(data.plot, type = "compare", year = 2023, interval = TRUE) +
  labs(title = "Illustrative country comparison")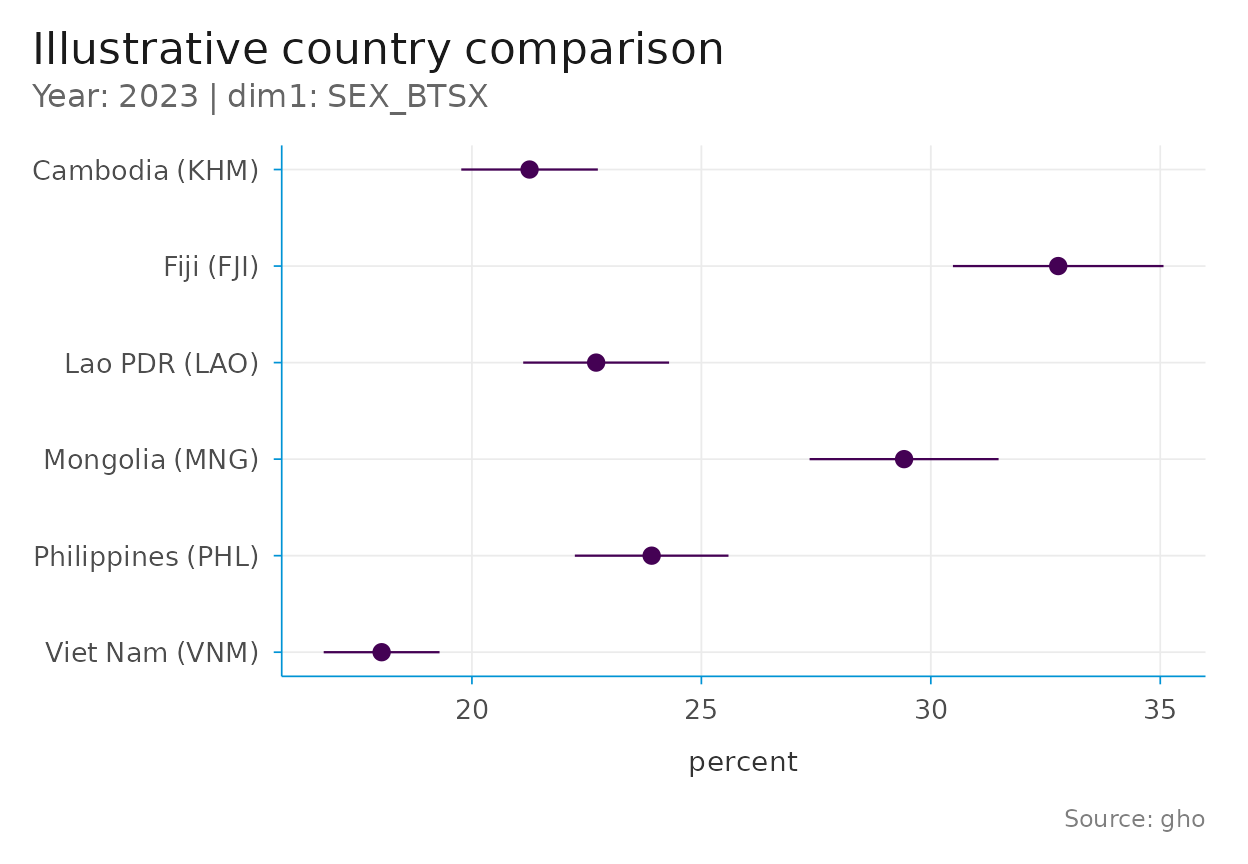
返回结果是标准
ggplot。原始数据提供的上下界显示为区间,不假定置信水平。国家比较使用同一年份;趋势线在缺失估计值或超过一年的间隔处断开。两种方法都不汇总数据或转换单位。绘图前选择单一指标、系列或度量及单位,再筛选其他分层,或通过
group 和 facet
指定列名。例如,按性别展示各国趋势可使用 group = "dim1" 和
facet = "iso3"。如果清洗时省略了取值不一致的维度,需要使用保留选项重新清洗。绘图相关字段变更后若标记为
needs_review,应先核查,再使用显式 ggplot 映射。
带区间的趋势线
low 和 high 可直接映射到
geom_ribbon()。绘图前先筛选一个人群分层,这里使用男女合计(dim1 == "SEX_BTSX")。theme_dsi_facet()
是适用于分面图的主题。
ncd |>
  filter(dim1 == "SEX_BTSX") |>
  ggplot(aes(year, value_num)) +
  geom_ribbon(aes(ymin = low, ymax = high), fill = "#0093D5", alpha = 0.2) +
  geom_line(color = "#0093D5", linewidth = 0.7) +
  facet_wrap(~ location_name) +
  labs(
    title    = "Premature NCD mortality is declining in most countries",
    subtitle = "Probability of premature death from NCDs, both sexes, 2000-2023",
    x = NULL, y = "%",
    caption  = "Simulated data for illustration."
  ) +
  theme_dsi_facet()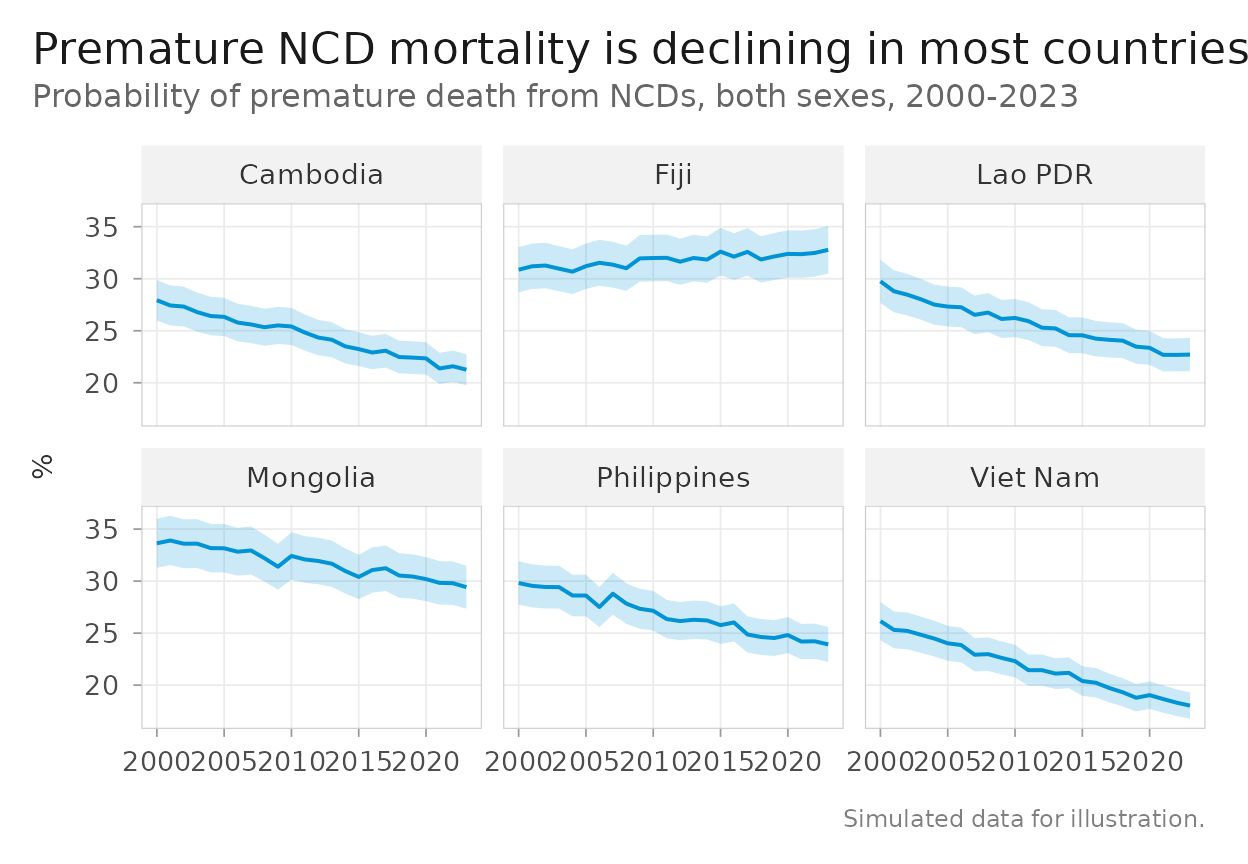
模拟区间用于演示绘图方式;用于真实分析时,应核对数据源对不确定性区间的定义。
展示 dim1 / dim2 / dim3 分层
旧版 GHO 的性别、年龄组等分层位于
dim1、dim2 和
dim3。可将分层映射到
colour,并使用色觉友好的配色,例如 ggplot2
提供的
scale_color_viridis_d()。本文模拟数据沿用旧版位置维度;使用
xMart 命名维度时,应按实际字段调整。
ncd |>
  filter(dim1 %in% c("SEX_MLE", "SEX_FMLE")) |>
  ggplot(aes(year, value_num, color = dim1)) +
  geom_line(linewidth = 0.7) +
  facet_wrap(~ location_name) +
  scale_color_viridis_d(end = 0.6,
                        labels = c(SEX_FMLE = "Female", SEX_MLE = "Male")) +
  labs(
    title    = "Men die prematurely from NCDs more often than women",
    x = NULL, y = "%", color = NULL,
    caption  = "Simulated data for illustration."
  ) +
  theme_dsi_facet()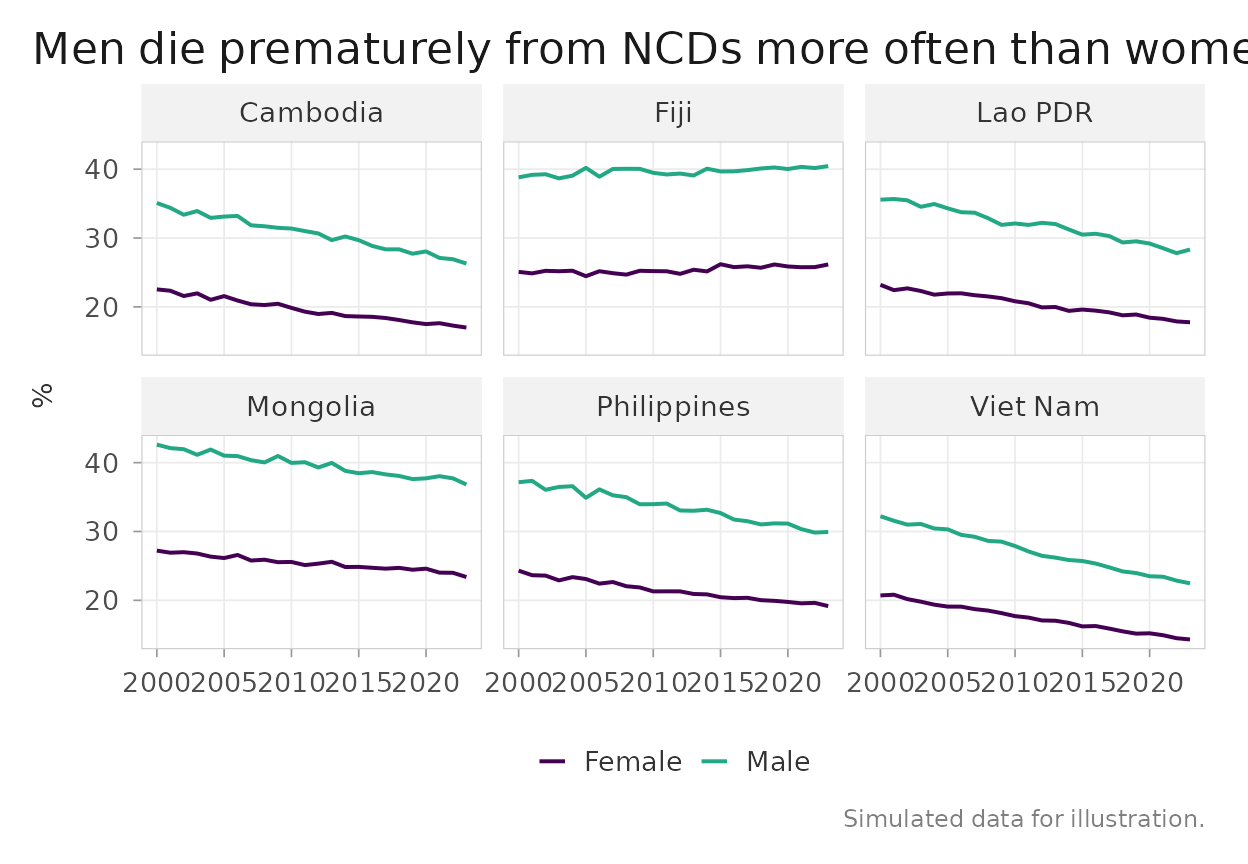
森林图式的国家比较
比较某一时点各国数值及其不确定性区间时,可取各国最新年份,再使用
geom_pointrange()。按数值排序坐标轴可使结果更易读。这里所有国家的最新年份相同;使用真实数据时,应检查年份是否一致。
latest <- ncd |>
  filter(dim1 == "SEX_BTSX") |>
  slice_max(year, by = iso3)

ggplot(latest, aes(value_num, reorder(location_name, value_num))) +
  geom_pointrange(aes(xmin = low, xmax = high),
                  color = "#0093D5", linewidth = 0.7) +
  labs(
    title   = "Premature NCD mortality, 2023",
    x = "%", y = NULL,
    caption = "Point estimate and 95% interval. Simulated data."
  ) +
  theme_dsi()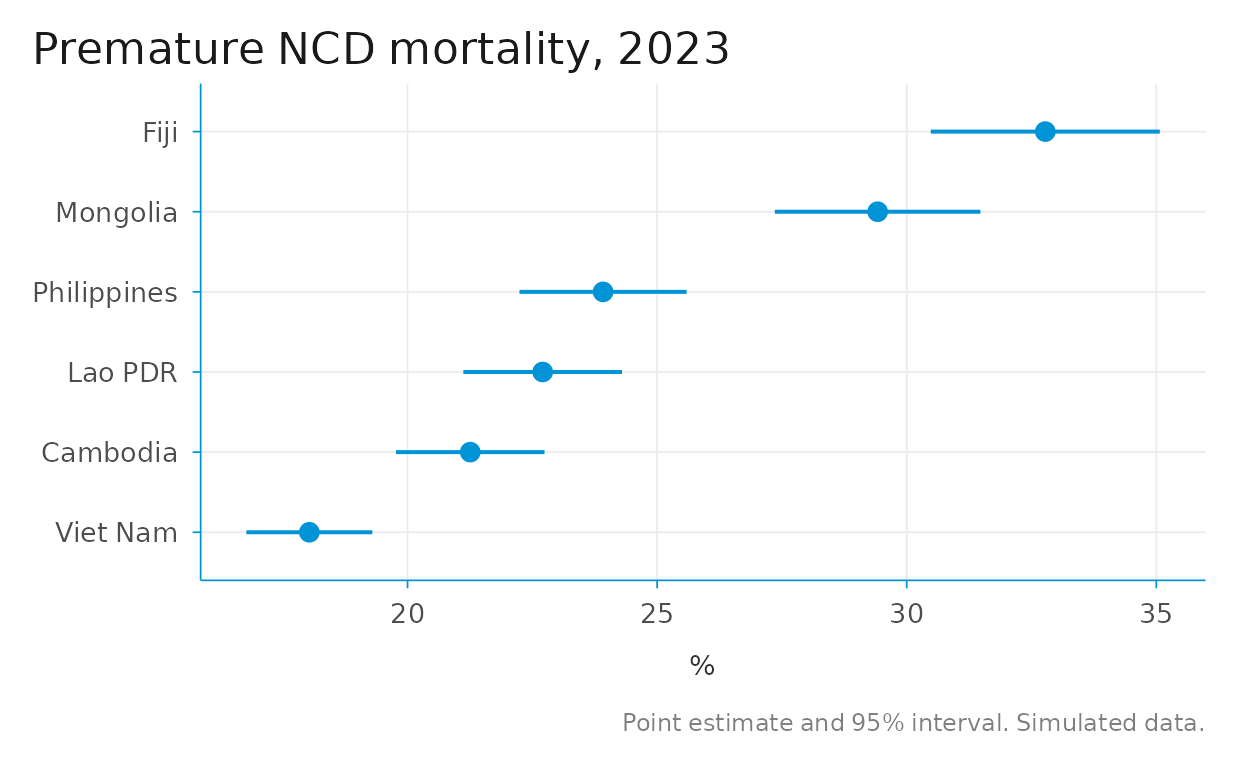
用哑铃图比较进展
哑铃图比较每个国家的两个时点。分别筛选两个年份,再通过连接形成宽表,无需额外的数据重塑包。示例颜色来自色觉友好的 Okabe–Ito 配色。
start <- ncd |>
  filter(dim1 == "SEX_BTSX", year == 2000) |>
  select(location_name, start = value_num)
end <- ncd |>
  filter(dim1 == "SEX_BTSX", year == 2023) |>
  select(location_name, end = value_num)

dumbbell <- start |>
  left_join(end, by = "location_name") |>
  mutate(
    direction     = ifelse(end < start, "Decline", "Increase"),
    location_name = reorder(location_name, start)
  )

ggplot(dumbbell) +
  geom_segment(aes(x = start, xend = end,
                   y = location_name, yend = location_name,
                   color = direction),
               linewidth = 1.5) +
  geom_point(aes(start, location_name), size = 3, color = "grey65") +
  geom_point(aes(end, location_name, color = direction), size = 3) +
  scale_color_manual(values = c(Decline = "#0072B2", Increase = "#D55E00")) +
  labs(
    title   = "Change in premature NCD mortality, 2000 to 2023",
    x = "%", y = NULL, color = NULL,
    caption = "Grey dot = 2000, colored dot = 2023. Simulated data."
  ) +
  theme_dsi()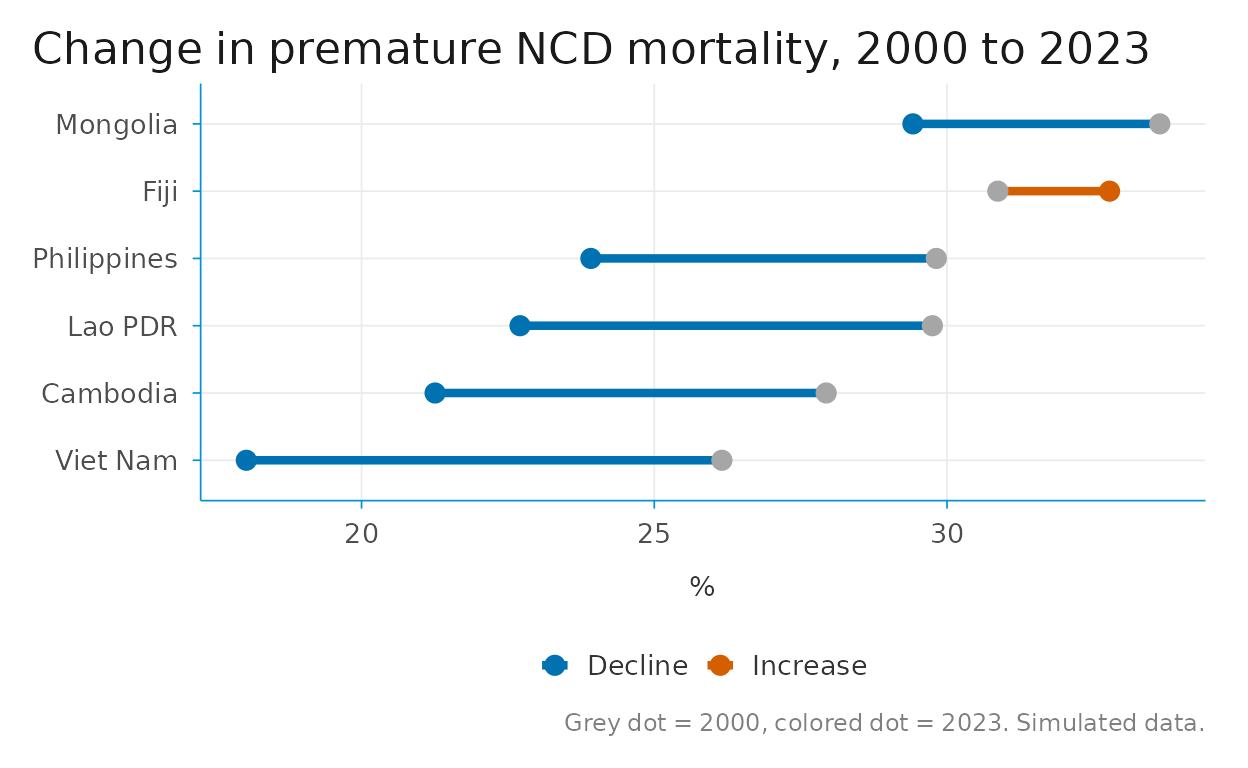
使用 aarr() 跟踪进展
aarr() 计算平均年度下降率(AARR),是 WHO 和 UNICEF
常用的进展度量。可在清洗后的数据上直接通过带 .by 的
summarise()
分组计算。请注意符号:正值表示指标下降。
progress <- ncd |>
  filter(dim1 == "SEX_BTSX") |>
  summarise(aarr = aarr(year, value_num), .by = c(iso3, location_name))

progress |>
  mutate(aarr_pct = round(100 * aarr, 1)) |>
  arrange(desc(aarr))
#> # A tibble: 6 × 4
#>   iso3  location_name     aarr aarr_pct
#>   <chr> <chr>            <dbl>    <dbl>
#> 1 VNM   Viet Nam       0.0159       1.6
#> 2 KHM   Cambodia       0.0117       1.2
#> 3 LAO   Lao PDR        0.0112       1.1
#> 4 PHL   Philippines    0.00995      1
#> 5 MNG   Mongolia       0.00600      0.6
#> 6 FJI   Fiji          -0.00240     -0.2
可按观测到的 AARR 将最新值向未来外推,作为粗略筛查。这不能替代官方 2030 年预测所使用的指标专属模型和假设。
latest |>
  left_join(progress, by = c("iso3", "location_name")) |>
  mutate(projected_2030 = value_num * (1 - aarr)^(2030 - year)) |>
  select(location_name, value_2023 = value_num, aarr, projected_2030) |>
  arrange(projected_2030)
#> # A tibble: 6 × 4
#>   location_name value_2023     aarr projected_2030
#>   <chr>              <dbl>    <dbl>          <dbl>
#> 1 Viet Nam            18.0  0.0159            16.1
#> 2 Cambodia            21.3  0.0117            19.6
#> 3 Lao PDR             22.7  0.0112            21.0
#> 4 Philippines         23.9  0.00995           22.3
#> 5 Mongolia            29.4  0.00600           28.2
#> 6 Fiji 32.8 -0.00240 33.3继续阅读:WHO xMart 与全球卫生估计。